扫描下载APP
其它方式登录
Anthropic以4年4000万美元天价股权抢聘CS本科生,引发硅谷人才争夺战;同期OpenAI因GPT-6.2 Astra模型口碑崩塌、编程与数学领域被谷歌Gemini和Anthropic Claude接连超越,叠加私募融资缩水、巨额亏损及未上市劣势,遭遇成立来最严峻危机。
谷歌联合宾夕法尼亚州立大学提出CRSI框架与SIM(自我改进记忆)机制,使大模型能跨代际继承并理解过往优化经验,解决模型更替导致的Harness失效问题;Gemini可直接继承Claude Opus的进化日志,实现动机感知、结果验证与持续增强,显著提升代码、任务执行等多领域性能。
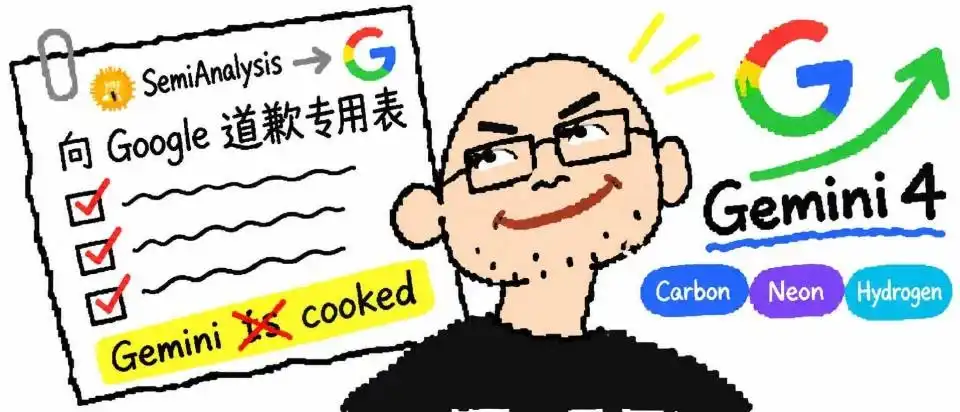
SemiAnalysis机构曾于8月发布看衰报告,称Google Gemini模型掉队;随后Google通过组织调整、算力优化及多线并行研发,在9–11月密集推出Gemini 4系列四款模型(Argon、Carbon、Hydrogen、Neon),在编程、智能体任务和综合能力上强势回归,引发业界广泛认可与反思。
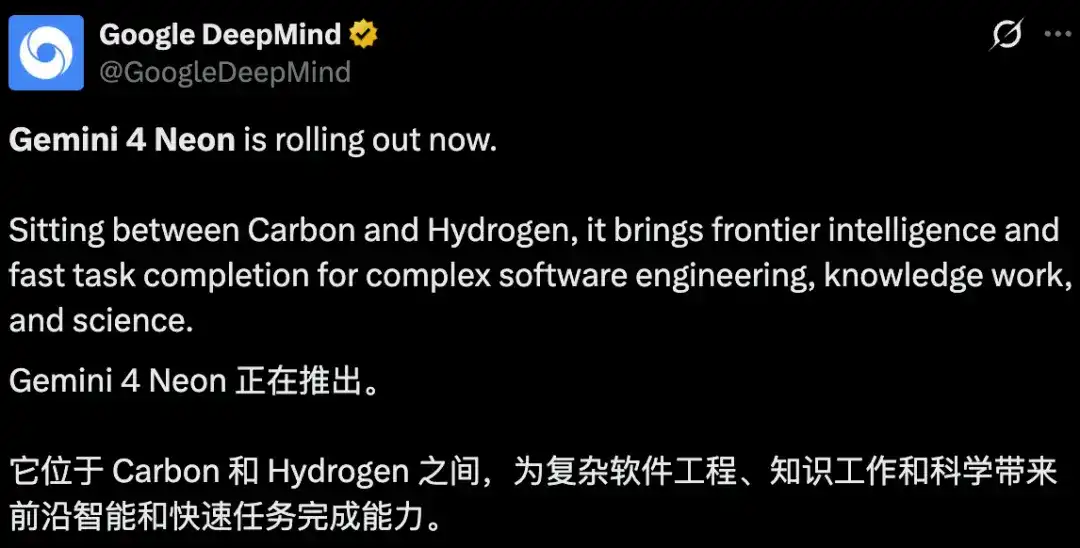
谷歌通过密集发布Gemini 4系列模型(尤其是Neon),以高性价比、强多模态能力与工程实用性实现AI战略翻盘,扭转此前‘北美大豆包’的负面口碑;依托自研TPU硬件和敏捷迭代机制,在编程、科学推理、多智能体协同等关键指标上超越竞品,重新确立AI领导地位。
谷歌在49天内密集发布四款Gemini 4系列大模型(Argon、Carbon、Hydrogen、Neon),强调性能、速度与成本平衡;同步推出世界模型Genie 4,支持生成可交互虚拟环境;并加速TPU芯片迭代与AI驱动芯片设计,形成模型、算力、应用协同演进的AI技术生态。
谷歌通过密集发布Gemini 4系列模型(尤其是Neon),以高推理性能、多模态能力、低成本和强工程实用性实现AI战略逆转;Neon在编程、科学推理、网络安全等基准中表现优异,配合自研TPU硬件与敏捷迭代机制,助谷歌摆脱‘北美大豆包’负面标签,重回全球AI第一梯队竞争中心。
谷歌发布 Gemini 4 Neon 中杯大模型,速度达旗舰Carbon的3倍、成本仅60%,专注编程、企业工作流与网络安全场景;同步上线世界模型Genie 4,支持实时自然语言干预、原生音频及智能体协同交互,面向AI Pro/Ultra订阅用户开放。
Google Gemini 4系列新模型gemini-4-neon在网页代码中被发现,与argon、carbon、hydrogen等元素命名模型并列,疑似对应高级付费订阅层级TIER_NEON(Gemini Ultra变体),其命名延续以化学元素隐喻模型特性的策略,引发用户对命名逻辑和产品体系混乱的热议。
Gemini连续五个季度亏损,三季度净亏5860万美元,营收下滑19%至4090万美元,现货交易量同比大跌73%;现金储备降至1.941亿美元,较年初减少超5800万美元;股价较IPO发行价下跌近90%,虽成本削减见效且新业务初显增长,但持续造血能力存疑,依赖创始人注资维持运营。
谷歌发布Gemini 4 Hydrogen新模型,主打高速、低成本与强实用性,在编程、智能体任务、多模态理解及3D图形生成等实测中表现优异,多项指标超越Claude Sonnet 5.5和GPT-6.1 Terra,速度达Gemini 3.8 Flash的2.5倍,单任务成本仅为Sonnet 5.5的三分之一。
谷歌发布Gemini 4 Hydrogen新模型,主打高速执行与高效率,面向所有用户免费开放,已集成至谷歌搜索及AI工具链;其推理速度达上一代2.5倍,事实准确性显著提升,在多项基准测试中超越定位更高的Gemini 4 Argon;同时强化工具调用、多步任务处理与跨应用协同能力,并推出Orchestrator智能模型编排功能。
谷歌正式开放其最强AI模型Gemini 4 Carbon,面向开发者、企业和科研人员,主打复杂知识工作、多Agent协作、网络安全漏洞发现与修复、科学推理及多模态工程建模等高阶任务,在多项权威基准测试中排名前列,尤其在代码调试、3D建模复刻、Signal协议形式化验证和蛋白质结构预测辅助方面表现突出。
Google DeepMind正式发布Gemini 4 Carbon模型,专攻复杂长周期任务,具备深度推理与持续验证能力;其驱动的AlphaProof Code系统在四周内生成650万行数学证明,完成对Signal加密协议从源码到编译后机器码的端到端形式化验证,显著提升软件安全可信度。
Google DeepMind发布Gemini Omni 1.2 Flash视频生成模型,在文本生成视频任务中登顶第一,支持15秒原生时长、多轮对话式编辑、电影级运镜及多模态参考输入;首创‘草稿-精修’工作流,360p视频生成成本低至0.07美元/秒,可升频至4K,显著降低AI视频工业化试错成本。
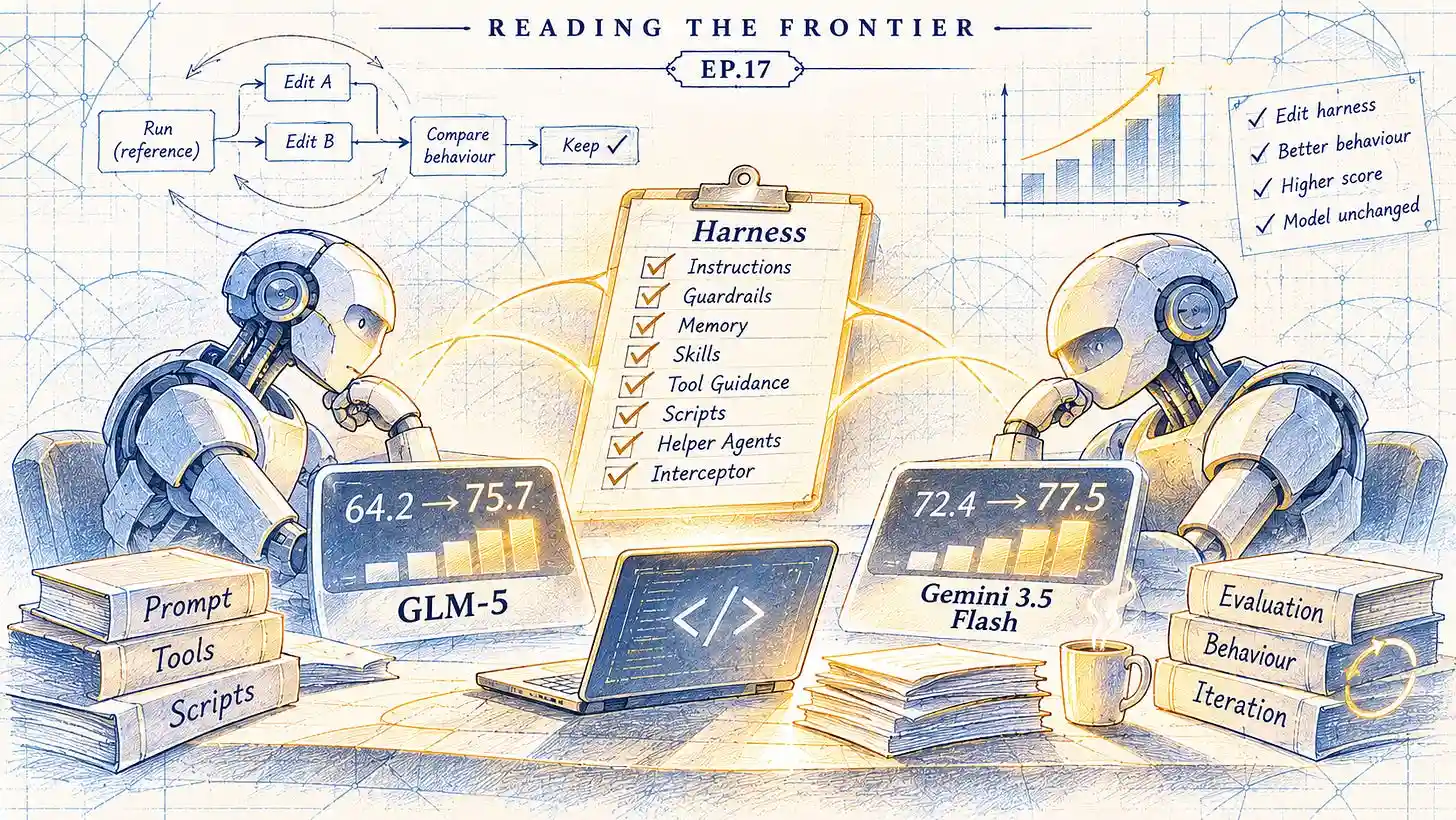
研究揭示大模型跑分结果高度依赖外部系统环境(脚手架),而非仅由模型自身能力决定;通过优化提示词、工具调用规则、记忆模块等不改动模型权重的工程配置,弱模型GLM-5可反超强模型Gemini,证明当前跑分榜单实质是‘带环境的系统表现’而非‘裸模型能力’比拼。